売上や広告、問い合わせの数字を確認するたび、データ担当へ抽出を依頼し、回答が届く頃には次の会議が迫っていてお困りではないでしょうか。自然な言葉で社内データを分析できても、同じ『売上』が部署ごとに違う意味なら判断は速くなりません。
原因は、質問方法より先に、指標の定義、正しいテーブル、更新時刻、閲覧権限が揃っていないことです。AIは複数のデータを調査できますが、古い表や誤った結合を正本として扱えば、見栄えのよい誤答を作る可能性があります。
この記事では、ChatGPT WorkのData agentを例に、質問からダッシュボードを作る前に必要な指標辞書、接続範囲、計算根拠の確認、5つの定例質問による小規模テストを解説します。専門外の担当者でも安全に分析を始めるための手順です。
株式会社ラクボは、AIツール導入だけでなく、データの正本、承認、例外処理、成果指標まで含む業務自動化を支援しています。速い回答より、次の行動に使える信頼性を優先した導入方法をお届けします。
Data agentは質問から調査と可視化まで進める
OpenAIが2026年9月に発表したChatGPT WorkのData agentは、承認された社内データへ自然な言葉で質問し、変化を調査し、インタラクティブなダッシュボードやレポートを作る機能です。Databricks、Snowflake、Power BIなどの接続先を管理者が設定し、利用者は会話を重ねながら分析を絞り込めます。
従来の一問一答と違い、『先月より受注率が下がった理由を地域と流入元で分けて』『その中で商談化までの日数が長い層を見せて』と追加質問できます。分析結果をSlackやメールで共有し、接続済みツールを通じて承認された操作へ進める設計も示されています。
ただし、自然な質問が正しい計算を保証するわけではありません。Data agentの価値はSQLを書かなくてよいことだけでなく、質問、調査、可視化、共有を一つの流れにできる点です。まずは毎週繰り返している一つのレポートを対象にします。
接続前に指標辞書と正しいデータ源を決める
接続前に、指標辞書を作ります。指標名、計算式、対象期間、除外条件、正本テーブル、更新頻度、責任者を一行で整理します。たとえば『商談化率』を、問い合わせ数に対する商談数とするのか、有効リード数に対する商談数とするのかを固定します。
次に、正しいデータ源だけを許可します。表計算、CRM、広告管理、会計など同じ数字を持つ場所が複数ある場合は、用途別に正本を決めます。OpenAIの社内データエージェントの解説でも、多対多の結合、フィルター、未処理の欠損値が結果を暗黙に誤らせる失敗例として挙げられています。
テーブル名だけでなく、値の粒度、更新時刻、含まれない対象も記録します。『今月』の締め時刻や、キャンセルを売上から除く時点を曖昧にしません。AIエージェントの制御を一元管理する設計と同じく、接続先と責任者を台帳化します。
権限・計算・根拠を人が確認して共有する
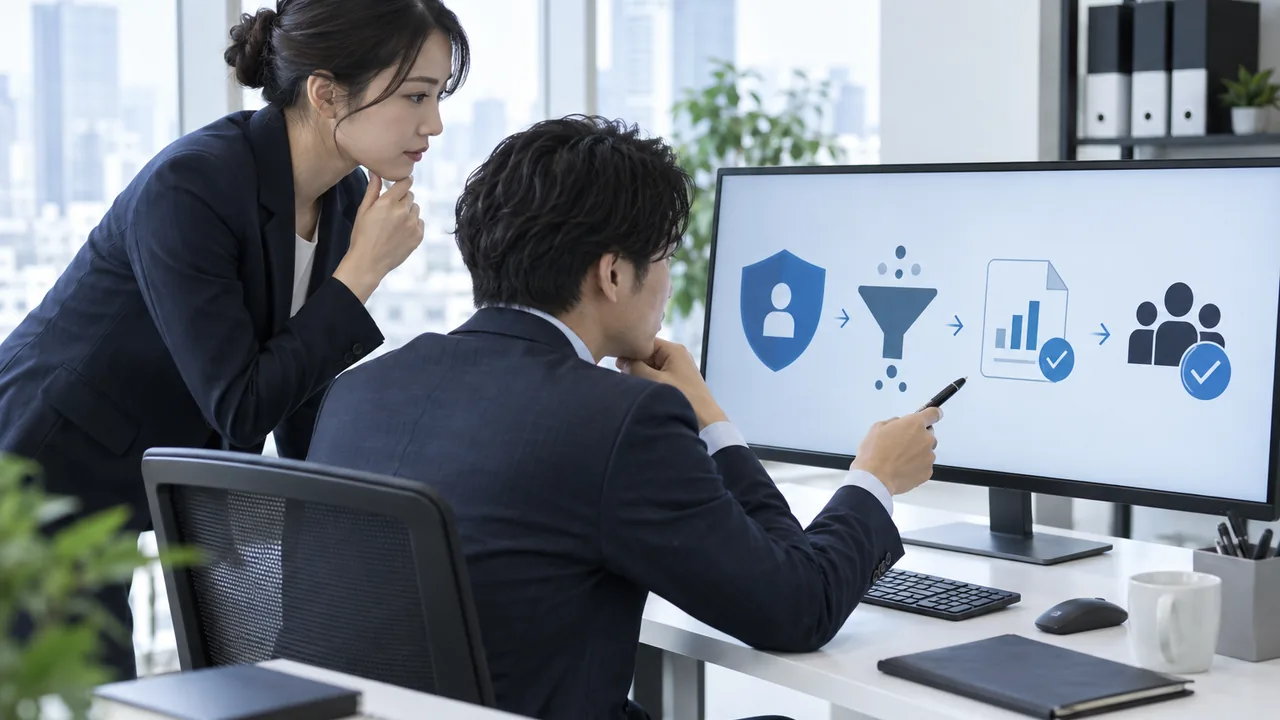
利用者には、元システムで必要な範囲だけを見せます。経営者、営業、広告担当で同じ接続権限にせず、個人情報、原価、給与などは列や行の単位で制限します。共有ダッシュボードも、作成者が見られたデータを全員へ公開しないよう、共有先の権限を再確認します。
回答を採用する前に、使用したテーブル、期間、フィルター、計算式、更新時刻を確認します。前月比が大きく変わった場合は、実際の変化だけでなく、計測タグ、CRM入力、重複排除、欠損値の扱いが変わっていないかを見ます。重要な経営判断では、既存レポートや元システムの合計と照合します。
誤りを見つけたら、会話内で直すだけでなく、指標辞書や接続設定へ戻します。個人の訂正をチームの正本へ反映しなければ、別の担当者が同じ誤りを繰り返します。分析ログには質問、参照先、回答、修正理由、承認者を残してください。
5つの定例質問で精度と時間を測って広げる
最初は『昨日の問い合わせ数』『週別の商談化率』『失注理由の上位』『広告費の予算差』『未対応案件』など、答えが既存レポートで分かる5問を選びます。Data agentの回答と正本を照合し、数値一致、使用した定義、回答時間、追加確認の回数を記録します。
5問が安定したら、地域別、商品別、流入元別の深掘りへ進みます。評価指標は、質問から判断までの時間、正しい回答率、訂正回数、データ担当への依頼削減数です。作成したグラフの数ではなく、会議で次の行動を決められたかを確認します。
社内データの整理からAI分析、承認、定例レポートまで少人数で仕組み化したい方は、ラクボのAI顧問・業務自動化支援をご覧ください。自社で試す5つの質問と接続範囲を整理したい場合は、データ分析自動化の相談窓口をご利用ください。