議事録や問い合わせ履歴を生成AIで要約したいのに、氏名、メールアドレス、契約内容が混ざっていて入力できないとお困りではないでしょうか。担当者が毎回手で伏せ字にすると時間がかかり、見落としも起こります。
原因は、AIの利用画面だけを対策し、元データの取得、整形、入力、出力、保存という経路全体を管理していないことです。氏名を消しても、住所、会社名、役職、案件内容の組み合わせから個人が推測できる場合があります。
この記事では、生成AIへ渡す前に個人情報をマスキングする流れを、対象分類、検出、置換、確認、記録まで具体化します。すべてを自動化する前に、一つの業務で安全性と時短効果を確かめる方法が分かります。
株式会社ラクボは、デジタルマーケティングとDX支援の現場で、生成AIの入力、権限、承認、ログを業務単位で設計しています。便利さだけでなく、誤送信や再識別を防ぐ運用まで含めて解説します。
マスキングはAI入力の直前ではなくデータ経路で設計する
マスキングとは、氏名や連絡先などを削除または置換し、AIへ直接渡さないようにする処理です。ただし、単に黒塗りや伏せ字にすれば法的な匿名加工情報になるわけではありません。個人情報保護委員会の匿名加工情報の説明も確認し、目的と扱いを区別します。
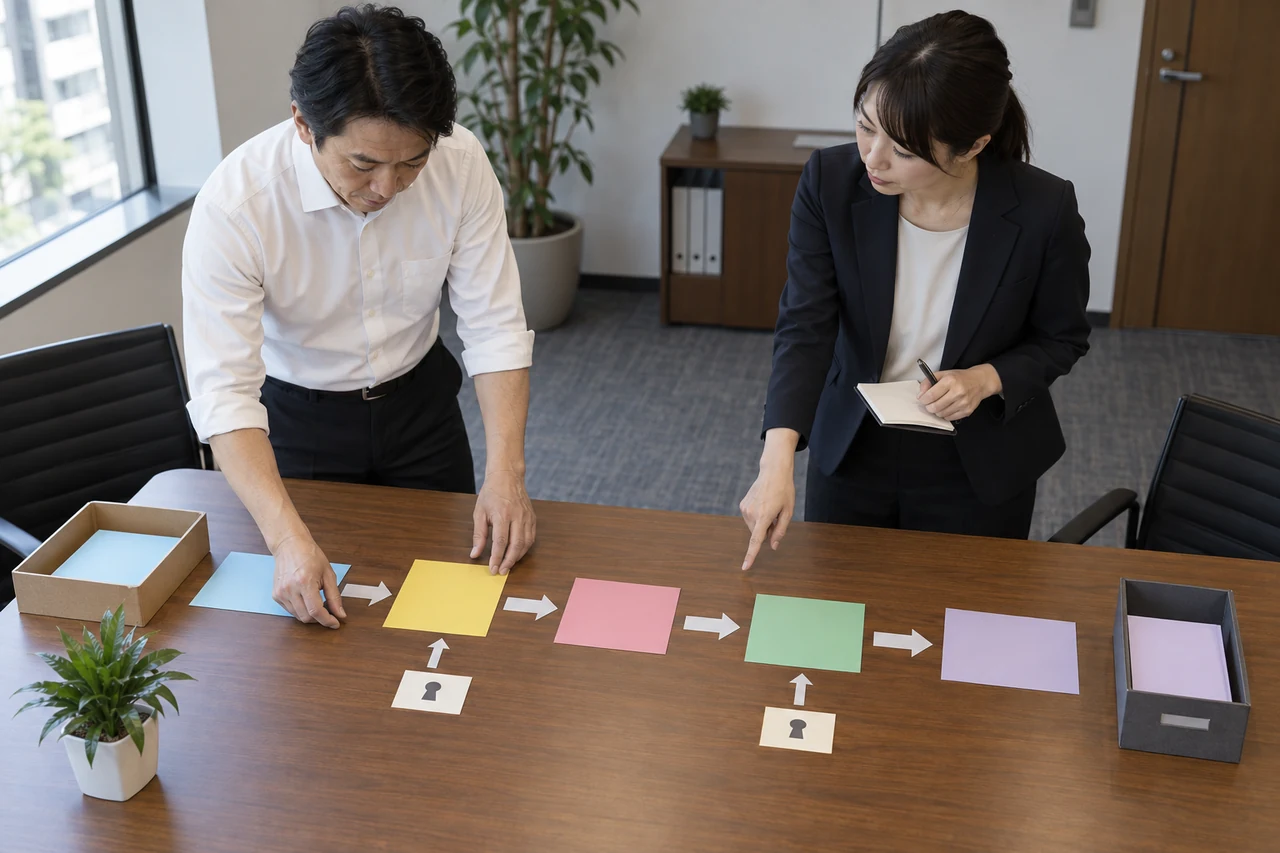
設計の起点はAIツールではなく、データがどこから来てどこへ戻るかです。たとえば問い合わせメールなら、受信、本文抽出、添付確認、マスキング、AI要約、担当通知、CRM保存までを一本の経路として描きます。各地点で誰が原文を見られるか、加工前後をどこに保存するかを決めます。
入力禁止にする情報、置換して使う情報、承認後だけ使う情報を分けます。特に本人確認情報、決済情報、健康情報、未公開の人事情報は、通常の連絡先と同じ扱いにしません。利用目的と必要最小限を先に決めると、機能追加のたびに判断が変わりにくくなります。
個人情報を検出・置換する四段階の実務フロー
第一段階は対象業務と項目の棚卸しです。氏名、電話番号、メール、住所、顧客番号だけでなく、自由記述、PDF、画像、録音の文字起こしも対象にします。第二段階で、正規表現、辞書、固有表現抽出などを組み合わせ、検出候補へ印を付けます。
第三段階では、削除だけでなく一貫した仮名へ置換します。たとえば同じ顧客を本文中で「顧客A」に統一すれば、AIは会話の流れを保ったまま要約できます。復元が必要な業務では、対応表をAIと分離した保管場所に置き、閲覧権限と保存期限を限定します。
第四段階で、マスキング後の文章を再検査します。本文だけでなく、件名、ファイル名、画像内文字、メタデータ、AIへの指示文も確認対象です。2026年には個人識別情報を検出するPrivacy Filterのような選択肢も増えましたが、ツール導入と業務上の合格基準は分けて決めます。
自動検出だけで終わらせず例外を人へ戻す
自動検出は、表記揺れ、誤字、文脈依存の固有名詞、画像に写った情報を見落とすことがあります。逆に一般語を個人情報として隠しすぎると、AIの要約や分類に必要な意味が失われます。そのため、検出結果を信じ切らず、漏れと過剰除去の両方を確認します。
例外時は原文をそのまま送らず、安全側に停止させます。検出できない添付、長すぎる入力、対応表の参照失敗、外部サービスの仕様変更が起きたら、担当者へ戻し、理由と対象IDだけを通知します。再開する際も、加工済みデータから始めるか原文からやり直すかを決めておきます。
人の確認は全件固定ではなく、重要度と検出信頼度で分けます。高リスク情報、初めての書式、低い検出スコアは全件確認し、定型文は抽出サンプルを確認します。権限と承認の考え方は、AIエージェントのアクセス権を棚卸しする方法と組み合わせると整理できます。
小さなテストで漏れと業務効果を同時に測る
最初の実証は、顧客対応や採用書類など影響の大きい業務を避け、社内議事録の要約など範囲を限定します。実データを使う前に、氏名、住所、メール、案件名、自由記述を含むダミー文書を作り、意図的な表記揺れや画像添付も混ぜます。
測る指標は、検出漏れ件数、過剰マスキング件数、人の確認時間、処理失敗率、AI出力の利用率です。十件程度を人手処理した基準と比較し、どの項目なら自動化でき、どこは承認が必要かを決めます。変更後は同じテストセットで再評価し、精度低下を見逃さないようにします。
マスキングは単独機能ではなく、入力制御、権限、ログ、削除期限をつなぐ仕組みです。自社のデータ経路に合わせて安全なAI活用を設計したい場合は、ラクボのAI顧問・AI部門代行をご覧ください。個人情報を含むAI業務の設計を相談できます。